MySql
MySql
MySql事务
事务:可以理解为是一组SQL语句的集合,被当做一个单一的工作单元执行,这些操作要么都成功,要么都失败。
事务的四种隔离级别
读未提交 RU
允许读取未提交数据
有脏读,不可重复读,幻读问题
读已提交 RC
Oracle 默认
事务中的读操作只能读取到其他事务已经提交的数据。每次读操作都会生成一个新的读取视图,并读取新的行版本,以此避免脏读。
由于是基于行的快照,所以有幻读,不可重复读问题。
可重复读 RR
MySql默认
通过多并发版本控制(MVCC)和行级锁实现。事务开始的时候创建一个一致性视图,之后的读取操作都基于这个视图进行,保证了在同一个事务中多次读取的结果一致性,解决了不可重复读的问题。此外,InnoDB存储引擎使用Next-Key Lock来防止幻读的发生,它结合了行锁和间隙锁,锁定了记录本身和记录前面的间隙。
仍然有幻读问题
串行化Serializable
没有问题
三种问题
脏读
脏读是指一个事务读取到了另一个事务尚未提交的数据变更。如果那个事务最终回滚,那么读取到的数据将是无效的。脏读通常在最低的隔离级别(如读未提交 Read Uncommitted)下可能发生。
不可重复读
不可重复读是指在一个事务执行过程中,多次读取同一数据集合时,由于其他事务的介入,后续读取的结果与前面的读取结果不一致。这通常是由于其他事务在这两次读取之间更新了数据。
幻读
幻读是指在一个事务执行过程中,多次执行相同的查询,由于其他事务插入或删除了符合查询条件的数据,导致后续的查询结果包含了之前不存在的记录(幻影行)。幻读通常发生在可重复读(Repeatable Read)或更高的隔离级别下。
不可重复读和幻读区别通俗理解为:前者是数据变了,后者是数据的行数变了。
隐式提交
没有使用指令
- 执行了DDL语句:create、drop、alter
- 开启了一个新的事务
- 使用了锁
- 使用了加载操作
事务四大特性
A原子性
即事务要么都成功,要么都失败
通过undo log实现的
undo log其实记录的是一个链表,链首为最新更改数据的信息,链尾为最早更改数据的信息(信息中其实就是改行所以的字段,通过不可见字段trx_id标记事务的id)
undo log会配合每一行记录的隐藏字段 row_ptr回滚指针实现回滚
C一致性
事务执行前后,数据库的完整性约束不会发生变化
I隔离性
事务之间相互隔离
D持久性
通过redo log 两阶段提交,保证crash safe
MVCC实现(MVCC多版本并发控制)
制定了关于快照读和当前读的相关内容
当前读:比如update、insert、delete以及加锁的select语句都会修改当前读
快照读:select语句读取的是快照读
快照什么时候建立?RC级别 每次快照读,都会建立新的快照
RR级别 第一次需要快照读的时候建立,之后会使用第一次的快照读
如何判断一个事务A能否看见B事务的值?
A事务自己的操作自己能看到
如果B事务没有提交看不到
如果B事务提交了
- 如果A事务快照建立在B事务提交之前,看不到
- 如果A事务快照建立在B事务提交之后,能看到
MySql锁
全局锁
FTWRL
命令 flush table with read lock
- 给库做备份的时候用,为了哪些没有事务的存储引擎使用
- 给库做备份也可以用Innodb开启一个事务进行备份
表锁
表锁
- 对于没有索引的遍历,都会加表锁
- 加锁:Lock Table
- 解锁:Unlock Table
元数据锁
- 更改表结构的时候会自动加元数据锁
- 加元数据锁会阻碍之后的所有操作,因此给表加字段最好加一个超时时间
意向锁
为了使行锁和表锁共存(多粒度锁机制)
- 加锁之前必须获取意向锁
- 可以减小加表锁时,还需要去遍历判断是不是有行锁的开销
- 意向共享锁IS
共享锁允许多个事务读取同一数据项,但不允许任何事务修改它。当事务想要在某个数据项上加共享锁时,它首先必须在该数据项上设置一个意向共享锁。这个锁告诉其他事务,有一个事务正在尝试读取这个数据项。 - 意向排它锁IX
排他锁允许事务对数据项进行读取和修改,但不允许其他事务读取或修改同一个数据项。当事务想要在某个数据项上加排他锁时,它首先必须在该数据项上设置一个意向排他锁。这个锁告诉其他事务,有一个事务正在尝试修改这个数据项。
行锁
加锁时机
原理 给索引加锁,因此如果有另外一个SQL在遍历时使用了该索引,那么也会进入阻塞
行锁在需要的时候会自动加上,但是不需要的时候不会立即释放,只有事务提交了才会释放行锁
两种锁实现
共享锁
select in share mode
排它锁
select..for update
update、insert、delete语句自动加排他锁
加行锁之前都得先去获得意向锁
间隙锁
解决幻读问题
当查询的是一个范围的时候,Innodb会给所有关联内的数据加锁,就是所谓间隙锁
原理
给一个范围加了一把锁,导致其他事务不能去操作,也就解决了幻读
死锁
如果两个事务,执行过程中分别拿了对面的锁,那么就会死锁
怎么解决?
- 可以设定一个超时时间
- 主动发起死锁检测,死锁后,主动回滚其中的一条事务,就可以解决(这也是Mysql的默认方式)
- 最好的办法是从设计上解决,可以控制并发量;可以将共享的数据多分几行,然后获取总数时加起来;
MySql主从复制
为什么要建立主从模型?
mysql是一个小型数据库,为了解决mysql小的问题,可以建立mysql集群,保证高并发下的稳定性
主从复制过程
mysql5.6之前
过程
- 主库将数据写入bin log中
- 从库有IO线程网络读取bin log日志
- IO会将读取的数据存放在relay log内
- 另一个线程SQL log会去执行relay log的数据,实现主从复制
存在的问题
主要就是复制过程太慢,主从延迟严重,主要就是因为第四步影响了复制的速度(因为这个过程是读数据往磁盘写,而操作磁盘是最慢的操作)
mysql5.6
实现了并行复制

引入了协调者线程Coordinator,负责将不同库的信息分线程去执行,增快速度
存在的问题
分的粒度太粗,是库级别的,其实性能并没有提高很多
mysql5.7
真正实现了并行复制,解决了主从复制的延迟问题
原理
组提交:
- 每个日志都有一个序列号 LSN,这个值单调递增,一段很短的时间内,可能有多个事务,比如100,120,150,提交时将LSN<150的一起提交
- 当事务同时提交时,它们将在单个操作中写入到二进制日志中。 如果事务能同时提交成功,那么它们就不会共享任何锁,这意味着它们没有冲突,因此可以在 Slave 上并行执行。所以通过在主机上的二进制日志中添加组提交信息,这些 Slave 可以并行地安全地运行事务。
其他问题
遇到慢查询怎么处理?
- 重复运行几次,看看是不是每次都这么慢
如果不是每次都慢,说明慢的那一次是在刷脏页 - 看是不是没索引
- 看索引是不是用错了
用错了?- 1、analyze table 表名 重新计算统计信息,说不定能用对索引
- 2、新建一个索引
- 3、force index强制使用一个索引
- 如果还慢,就要看慢查询日志,查看具体慢的原因了
如何选择字段建立索引?
- 小于2000行的表无需建立索引
- 选择基数大的(区分度大的)作为索引,可以用show index查看
- 优先用普通索引,可以利用changebuffer,将随机读变为顺序读
- 不要选择太长的字段,因为每个辅助索引都会记录聚簇索引的值
什么时候刷脏页?
- redo log日志写满了,如果继续写会覆盖之前的内容,所以需要把之前的脏页写回磁盘
- Mysql当前很忙,请求很多,导致需要频繁的置换页面,当置换脏页的时候,就得写磁盘
- Mysql很闲的时候,判断当前很闲,就会刷脏页
- Mysql关闭的时候,需要把所有脏页写回磁盘
行记录的不可见的字段
- row_ptr:回滚指针,与undo log配合实现回滚操作
- row_id:隐藏主键,如果你没有设定主键,那么会选择唯一键当主键,如果没有唯一键,就会创建一个6字节的隐藏字段row_id作为主键
- trx_id:修改当前记录的事务的id号
如何存储emoji表情?
使用utf-8mb4而不是utf-8,否则会乱码
行记录的不可见的字段
- row_ptr:回滚指针,与undo log配合实现回滚操作
- row_id:隐藏主键,如果你没有设定主键,那么会选择唯一键当主键,如果没有唯一键,就会创建一个6字节的隐藏字段row_id作为主键
- trx_id:修改当前记录的事务的id号
如何存储emoji表情?
使用utf-8mb4而不是utf-8,否则会乱码
自增ID用完了会发生什么?
- 自己设置的非空唯一主键,如果用完了,mysql会报错
- 如果是row_id,就会覆盖掉原本的数据
怎么解决自增ID用完了?
- 换一个索引,比方说换到邮戳类型
- 使用bigInteger存
- 建立联合索引,用主键和其他字段建立联合索引
- 使用UUID或是SnowFlake
数据库概念
码
候选码
能唯一标识一个元组,而其子集不能
主属性
候选码的属性为主属性
非主属性
不是主属性就是非主属性
依赖
什么是依赖?
一个x可以唯一确定一个y,x ->y, 就称y依赖于x
部分依赖
假如x -> y,而且x的一个真子集x’ -> y,此时称为部分依赖
完全依赖
假如x -> y,而且x的任何一个真子集都不存在x’->y,此时就成为完全依赖
传递依赖
假如x->y,y-/->x,y->z,就有x->z,则称z对x传递依赖
数据库范式
第一范式
列不可拆分,列是原子列
第二范式
在第一范式的基础上消除了非主属性对键的部分依赖
第三范式
在第二范式基础上消除了非主属性对键的传递函数依赖
BC范式
在第三范式基础上,消除了主属性对键的部分
MySQL架构

客户端
Server层
连接器
- 与客户端连接
- 验证权限
查询缓存
- 将查询结果存放至查询缓存
- 很容易过期,在最新版本mysql已经去除查询缓存
- 适合存放长期不会改变的数据
分析器
分析sql语句、是否有语病
优化器
- 生成执行计划
- 决定用什么索引
- 决定join时表的连接方式
- 优化Sql语句
执行器
操作存储引擎
存储引擎层
MyISAM
- B+树结构辅助索引存放主索引的地址
- 只有表锁
- O(1)级别count
Innodb
- 支持外键
- 支持事务
- B+树结构辅助索引存放主索引的值
- 引入了行锁
- Innodb三大特性
- 插入缓冲:
- 优化了普通索引,引入了change buffer
- 先判断插入的普通索引页是否存在缓冲池中,如果在就可以直接插入,如果不在就先放到change buffer中,然后进行change buffer 和普通索引的合并操作,可以将多个插入合并到一个操作中,提高普通索引的插入性能
- 两次写:防止实例宕机时,innoDB发生数据页部分写的问题
- 自适应哈希:innoDB有一个机制可以监控索引的搜索,如果innoDB注意到查询可以通过建立索引得到优化就会自动完成这件事
- 插入缓冲:
| 对比项 | MyISAM | Innodb |
|---|---|---|
| 外键 | 不支持 | 支持 |
| 事务 | 不支持 | 支持 |
| 行表锁 | 表锁,即使操作一条数据也会锁住整个表 | 行锁,操作时可以只锁住某一行;适合高并发 |
| 缓存 | 只缓存索引,不缓存真实数据 | 不仅缓存索引,还会缓存真实数据;对内存要求高 |
| 表空间 | 小 | 大 |
| 关注点 | 性能 | 事务 |
memcache
存储结构为HashMap
MySQL基本操作
注释
- # 注释内容
- - - 注释内容
DDL
数据定义语言,用来创建数据库
关键字
create
操作库
create database 库名
create database if not exists 库名
create database 库名 character set utf8
操作表
- create table 表名(列名1 数据类型1, 列名2 数据类型2…)
alter
- 基本语法 alter database 库名称 character set utf8
drop
- 操作库 drop database 库名
- 操作表 drop table 库名
DML
数据操作语言
关键字
insert
insert into 表名(列名1, 列名2, …, 列名n) values (值1, 值2, 值n)
delete
- delete drop truncat的区别
- delete 不加where条件删除所有数据,会保留自增主键,速度较慢
- drop 删除所有数据会将表结构也一起删除
- truncate 如果要删除表的所有数据使用此命令,速度很快 自增主键会被重置
- delete from 表 where条件
update
update表名 set 列名1=值1,列名2=值2 where条件
DCL
数据控制语言
关键字
grant
revoke
DQL ☆
数据查询语言
select
基本语法
select 字段 from 表 where 条件 group by 字段 having 条件 order by 条件 limit 几个
select
查询不要使用*
会增加分析器解析成本,无用的字段会增加网络消耗
DISTINCT
- select distinct 字段 from表
- 去除重复数据
- 如果有多个null值,不会合并为一个
- 如果有多个字段,只有所有的字段都相同才会去重(不是标在谁前面就去重谁)
AS
给字段加别名
where
大小运算符
- > >=
- < <=
- <> !=
范围查询
- between A and B 闭区间 相当于 >= && <=
- IN(A, B, C) 多个or并列使用
逻辑判断
- and &&
- or ||
- not !
是否为null
IS NULL 判断是不是null最正确的方式
模糊查询 like
- 使用通配符
- % 匹配0个或者多个
- 不会匹配null
- 不要用在开头,这样不会用索引,影响性能
- _匹配1个
- % 匹配0个或者多个
group by
- 分组之后查询的字段必须是该分组字段或者聚合函数
- HAVING
- 分组后增加判断条件
- having 与 where的区别
- where是在分组前进行筛选;having在分组后筛选
- where不能使用聚集函数,having可以
order by
ASC升序;DESC降序 默认是升序
可以接多个字段进行排序
select id, price, name, from product order by price, name
表示先按price排序,再按name排序
这条语句会选择product表中的id、price和name列,并且首先根据price列进行排序,如果price相同,则根据name列进行次级排序。这意味着,你会得到一个结果集,其中的记录首先是按照price升序排列的(如果没有指定ASC或DESC,默认为升序),如果price相同,则这些记录会进一步按照name升序排列。
升序降序一起使用
select id, price, name from product order by price DESC, name
表示按price逆序,再按name升序 前面主要 后面次要
排序默认不区分大小写,但是可以设置
排序详解
MySql 会分配一个内存 排序 叫做 sort buffer ,但整个排序过程不一定在sort buffer 中执行,如果大小不足会在外存进行排序(归并排序,生成多个文件进行排序)
order by 两种排序方式
- 全字段排序
- 将所有字段读入sort_buffer
- 按指定字段排序
- 返回结果
- rowId排序(如果排序的字段内容单行长度就很大)
- 将row_id与指定字段读入 sort buffer
- 按照指定字段排序,得到排序后的row_id
- 用row_id读取数据返回
区别在于rowid会读取两次数据,比全字段排序慢一点
limit
limit m, n
- m从第几行开始 默认从0开始, n表示读几行
- limit 10 从第一行开始读10行
- limit 10, 10 从11行开始读10行
- limit(pageNum - 1) * pageSize, pageSize 实现分页
聚集函数
count相关
- 对于MyISAM引擎,总数就是一个表的字段,所以MyISAM返回count(*)非常快
- 但是Innodb没有这个字段,就得遍历表,挨个搜
- 为什么Innodb不设置这个字段?
是因为Innodb支持了事务,如果有这个字段,那么多个事务增删完数据就得更改这个共享的字段,实现又得加锁,很复杂 - 为什么不用统计信息table_rows那个字段?
只是个估计值
- 为什么Innodb不设置这个字段?
- Mysql对Count()的优化
mysql在执行count()这个语句的时候,mysql会去找这个表最小的索引树去遍历 - count()统计null吗?
- 如果为count(*)或count(1) 会统计null
- 如果为count(列) 不会统计null
- count之间的速度排序
- count(*) == count(1) > count(主键) > count(列)
- 表越来越大,count()的速度会越来越慢,如何解决?
自己计数 使用 Redis 存放表的数量信息
连接查询
- union
- 左右表的个数需要一致
- 相同的字段会合并
- inner join(只写join和这个一样)
理解为“有效连接”,两张表中都有的数据才会显示 - left join 理解为“有左显示”,比如on a.field=b.field,则显示a表中存在的全部数据及a、b中都有的数据,a中有、b中没有的数据以null显示
- right join 理解为“有右显示”,比如on a.field=b.field,则显示b表中存在的全部数据及a、b中都有的数据,b中有、a中没有的数据以null显示
- full join 返回两个表中的行:left join + right join(重合部分的相等数据只保留一份)
- cross join 结果是笛卡尔积,就是第一个表的行数乘以第二个表的行数。
- 使用on和where的区别
- 数据库在通过连接两张或多张表来返回记录时,都会生成一张中间的临时表,然后再将这张临时表返回给用户
- on决定了这张临时表的生成
- where是在临时表生成后才去筛选过滤
MySQL高级特性
CTE(公共表表达式)
CTE(Common Table Expression,公共表表达式)是从 MySQL 8.0 开始支持的特性,可以在一条 SQL 语句中定义临时命名的结果集,类似子查询但更易读、可复用。
基本语法
1 | WITH cte_name AS ( |
使用场景
1. 简化复杂查询
1 | -- 场景:查询每个部门工资高于部门平均工资的员工 |
2. 多层嵌套替代
1 | -- 场景:查询订单中购买次数最多的商品 |
3. 递归 CTE(树形结构查询)
1 | -- 场景:查询组织架构(员工及所有上级) |
4. 递归 CTE(层级结构)
1 | -- 场景:查询分类树(商品分类多级结构) |
CTE vs 子查询对比
| 维度 | CTE | 子查询 |
|---|---|---|
| 可读性 | 高,可命名 | 嵌套层次深时可读性差 |
| 复用性 | 可在主查询中多次引用 | 每个位置需重复定义 |
| 调试 | 独立,可单独测试 | 难以单独测试 |
| 递归 | 支持递归 CTE | 不支持 |
LATERAL(横向关联查询)
LATERAL 是 MySQL 8.0+ 的关键字,允许在 JOIN 中引用同一行中左侧表的列,实现更强大的关联查询能力。
基本语法
1 | SELECT ... FROM main_table, LATERAL(subquery) AS alias; |
为什么需要 LATERAL?
普通子查询只能独立执行,无法引用外层表的列。而 LATERAL 让子查询可以”看到”外层表的每一行数据。
使用场景
1. 每组取 Top N
1 | -- 场景:查询每个部门工资最高的前 3 名员工 |
2. 计算动态累计值
1 | -- 场景:查询每个月的销量以及当年的累计销量 |
3. 每行执行独立计算
1 | -- 场景:查询每个产品及其最贵的配件 |
4. 关联分页查询
1 | -- 场景:用户列表,每个用户显示最近 5 条订单 |
5. 动态 JSON 构建
1 | -- 场景:查询每个部门,并构建该部门所有员工的 JSON 数组 |
LATERAL vs 普通 JOIN 对比
| 维度 | LATERAL | 普通 JOIN |
|---|---|---|
| 子查询引用外层列 | ✅ 支持 | ❌ 不支持 |
| 独立性 | 每行独立执行 | 全局执行一次 |
| 适用场景 | Top N、动态计算 | 标准关联查询 |
| 性能 | 可能较慢(逐行执行) | 通常较快 |
注意事项
- 性能考虑:LATERAL 子查询会为外层每一行执行一次,数据量大时可能较慢
- 索引优化:确保外层表的连接列有索引,减少扫描次数
- MySQL 版本:需要 MySQL 8.0+,旧版本不支持
- ** CROSS JOIN**:LATERAL 默认是 CROSS JOIN,需要配合 WHERE 或 ON 条件过滤
MySql数据类型
char与varchar
char不可变字符串
char(10)就分配10个字符的空间,小于10个字符就会自动填充空格
varchar可变字符串
varchar(10)表示最大为10个字符,实际占用的字符为实际长度(实际会多一个字节来标识长度)
utf8与utf8mb4
- mysql中的utf8并不是实际上的utf8
- 如果要存储emoji就得使用utf8mb4
- utf8mb4才是真正使用四字节存储的数据库
时间类型
DateTime与TimeStamp的区别
时间范围
- DateTime没有时间范围
- TimeStamp有时间范围1970-2038年
- 到了2038年 mysql迁移到64bit 使用 datetime类型
时区问题
- DATETIME 在存储日期数据时,按实际输入的格式存储,即输入什么就存储什么,与时区无关;
- TIMESTAMP 值的存储是以 UTC(世界标准时间)格式保存的,存储时对当前时区进行转换,检索时再转换回当前时区。即查询时,根据当前时区的不同,显示的时间值是不同的。
MySql索引
存储结构
B+树
为什么使用B+树?
有一个发展过程
- 最开始使用HashMap存储
- HashMap必须一次性全部放入内存
- HashMap存在哈希碰撞问题,严重会使查询效率下降
- HashMap不支持范围查询
- 然后使用二叉树
- BST 树 不能保证平衡
- AVL 树 虽然实现了平衡,但是增删的速度优点慢
- 红黑树 平衡了增删与查询,但是存在一个问题,就是树高会很高
- 多叉树
- B树 索引与数据存放在同一数据块中,这样会使树很高
- B+树 引入内部结点与外部节点,内部结点全部存放索引,外部节点全部存放数据
B树相对B+树的优势
- B树相较于B+树更适合小数据量
- B树的某些优化,可以让查询频率高的数据更靠近根节点,从而优化的更快。而B+树必须要遍历到叶子结点
两种存储引擎存放的结构
MyISAM索引
辅助索引的叶子结点存放的是聚集索引的地址
Innodb索引
辅助索引的叶子结点存放的是聚集索引的值
所以我们选择主索引一定要选那些短的索引
索引的分类
单列索引
主键索引
是数据库中的一种特殊类型的索引,它基于表的主键(Primary Key)创建。主键是表中每一行记录的唯一标识符,因此主键索引的主要目的是确保数据的唯一性和快速检索。唯一索引
唯一索引(Unique Index)是数据库中的一种索引类型,它的作用是确保一个或多个列(索引列)的组合在表中是唯一的。这意味着,任何尝试插入或更新记录,如果会导致违反唯一性约束,都将被数据库拒绝。普通索引
是数据库中最基本的索引类型,它允许在表的一个或多个列上创建,以加快数据检索速度。与唯一索引不同,普通索引不强制要求索引列的值是唯一的,因此相同的索引值可以在表中出现多次。
联合索引
是数据库中一种特殊的索引类型,它包含两个或更多列的组合。这种索引允许数据库引擎在查询时更高效地定位数据,因为它同时考虑了多个列的值。联合索引对于优化涉及多个列的查询特别有用,尤其是当这些列经常一起出现在查询条件中时。全文索引
全文索引是专门为了提高文本数据检索的效率和精度而设计的索引。它通常用于大型文本数据的搜索,如文章、博客帖子、评论等。全文索引的工作原理是将文本分解成单词或短语(称为“token”),然后对这些token建立索引。这样,当用户进行搜索时,数据库可以快速找到包含这些单词或短语的记录。前缀索引
- 用字段的一部分作为索引
- 特点
- 节省内存
- 查询的次数比一般索引多
索引查询特性
回表
我们在搜索的时候定了很多列,而辅助索引中不完全包含这些列,就会从辅助索引查到主键索引找到完整的行去找。这就
索引覆盖
- 当你查询的数据只是辅助索引和主键的值时,只需要查辅助索引的B+树即可
- 可以用来优化sql
- 这里id是聚集索引,value是普通索引
- 优化前:select * from table1 where value = 100 limit 300000,10
从为value建立的索引上找到300010条value=100的记录的id,再拿这300010个id去主键索引找到对应的叶子结点,拿到每个id对应的数据返回。这种方式下,sql的执行非常耗时 - 优化后:select id from table1 where value = 100 and id > xxx and xxx …. limit 10
索引下堆
ICP
index condition pushdown
低版本的Mysql遇到多个索引时,是拿一个索引查,剩下的索引用来筛选
会回表Mysql5.7后,会使用多个索引直接去存储引擎查
具体来说,在没有使用ICP的情况下,MySQL的查询过程为:
- 存储引擎读取索引记录;
- 根据索引中的主键值,定位并读取完整的行记录;
- 存储索引把记录交给Server层去检测该记录是否满足WHERE条件。
使用ICP后的查询过程:
存储引擎读取索引记录(不是完整的行记录)
判断WHERE条件部分能否用索引中的列来进行检查,如果条件不满足,则处理下一行索引记录
条件满足,使用索引中的主键去定位,并读取完整的行记录。
存储引擎把记录交给Server层,Server层检测该记录是否满足Where条件的其余部分。
当你使用联合索引查询时,会优先考虑最左边的索引值
联合索引的最左匹配原则,在遇到范围查询(如 >、<)的时候,就会停止匹配,也就是范围查询的字段可以用到联合索引,但是在范围查询字段后面的字段无法用到联合索引。注意,对于 >=、<=、BETWEEN、like 前缀匹配的范围查询,并不会停止匹配。
为什么>就会断开,>=却依然可以?
假设是where a >= 1 and b = 2
对于符合 a = 1 的二级索引记录的范围里,b 字段的值是「有序」的
分多种情况,假设有联合索引ABC
- ABC都给了准确的值 会使用ABC的索引去查
- AB给了值,但是C没有 只会使用A的索引去查
- AC给了值,但是B没有 只会使用A的索引去查
- 使用到了字符串通配符匹配,当%不为开头时,可以使用索引
- 对A进行了范围查询 可以使用索引
- 对BC进行了范围查询 不能使用索引
- 对ABC任意两个及以上进行范围查询 不能使用索引
索引的选择法则
- 表的记录较小,小于2000,不需要建立索引
- 索引最好选择与业务无关的自增字段 与业务无关的自增字段可以保证减少B+树为了自平衡的一些操作
- 聚集索引不要选择很长的字段 因为所有的索引都会存储聚集索引的值
- 如果业务没有需求,请尽量使用普通索引而不是唯一索引
- 普通索引可以使用缓存池中的change buffer,加快随机写磁盘的速度
- 唯一索引每次都要读所有数据保证唯一性
- 选择区别度大的字段作为索引,可以根据基数判断 命令 show index from 表
MySql日志
Mysql 三种日志:bin log、redo log、undo log
WAL(Write Ahead Logging):先写日志,再写磁盘
这里先做一个简单的介绍:
bin log:存放所有的更新操作(逻辑存储)redo log:配合bin log使用,也是存放所有更新操作(物理存储)undo log:负责事务的原子性,保证可以回滚
其中 bin log 属于 Mysql Server 层级别、redo log 与 undo log 属于 Innodb 存储引擎级别
bin log redo log
bin log 与 redo log 会一起使用,bin log 相当于总账本,而 redo log 想当于记录今天流水的账本,之后 Mysql 会将 redo Log 的内容写到 bin log 内(二阶段提交,下文会介绍)
注意:
bin log与redo log大小固定redo log可以设置为一组四个文件,每个文件大小为 1GB

checkpoint:擦除的位置,checkpoint 之前的数据将数据更新到数据文件
write pos:记录当前位置
两个指针都是循环写,即写到最后,又从头开始,循环使用这一部分空间
redo log实现了crash safe
crash safe:保证 Mysql 出现故障后,之前的数据也不会丢失的能力
基本作用
binlog(binary log):记录对数据库的修改操作(增删改、表结构修改),会校验事务的完整性(事务 begin commit),也有备份点用于还原数据。主库可以使用 binlog 去备份出从库
redolog:WAL 写前日志,在写入 binlog 数据前,先写入 redolog,作为 crash safe 的安全保障手段,redolog 可以恢复在断点时那些没能刷回磁盘的数据。
为什么要有 redolog?
数据写入的过程是:先写入内存,缓存够一部分后,再刷脏页刷入磁盘中
内存的数据是易失的,如果发生断电,那么缓存的数据就会丢失掉,因此引入的解决办法是写前日志 WAL
写入 binlog 前,先写 redolog,这样可以减少数据丢失
bin redo区别
三大区别:
- 级别不同:
redo log是InnoDB引擎特有的;binlog是MySQL的Server层实现的,所有引擎都可以使用。 - 存储内容不同:
redo log是物理日志,记录的是 “在某个数据页上做了什么修改”;binlog是逻辑日志,记录的是这个语句的原始逻辑,比如 “给 ID=2 这一行的 c 字段加 1”。 - 写的方式不同:
redo log是循环写的,空间固定会用完;binlog是可以追加写入的。“追加写” 是指 binlog 文件写到一定大小后会切换到下一个,并不会覆盖以前的日志。
bin redo 如何联系
它们有一个共同的数据字段,叫 XID。
崩溃恢复的时候,会按顺序扫描 redo log:
- 如果碰到既有
prepare、又有commit的redo log,就直接提交 - 如果碰到只有
prepare、而没有commit的redo log,就拿着 XID 去binlog找对应的事务
rodolog 如何判断崩溃?
两阶段提交
- 如果redo log内事务为commit 直接提交
- 如果redo log 事务为prepare
- bin log事务存在且完整 提交
- bin log 事务不存在或不完整 回滚
bin log 如何判断完整性?
对于不同的数据,bin log有不同的标识其结束的标志
二阶段提交
由来:由于 bin log 与 redo log 属于不同的级别(bin log 属于 mysql
级别,而 redo log 与 undo log 属于 Innodb 级别),
为了保证数据同步,就得保证这两个文件一致,所以有了二阶段提交的概念
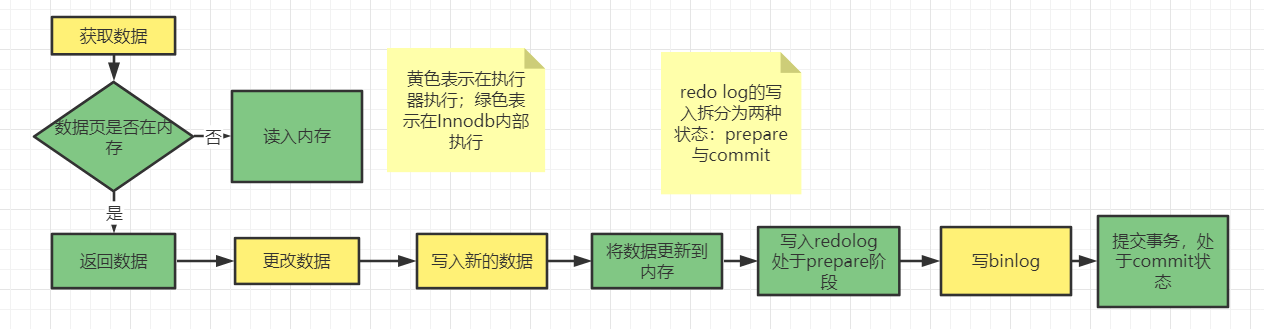
两状态提交:有两个状态
prepare与commit数据要进行更新时,会先写日志,再去更改数据,这个过程会先去写
redo log,将状态设置为prepare状态;(咔嚓~~~~如果此时断电,因为
binlog数据还没有写入,所以会丢弃redo log中的prepare这部分数据,并且进行回滚)然后再写
bin log;(咔嚓~~~~如果此时断电,因为
bin log已经写入,判断redo log中也存在,只不过状态是prepare,依然可以继续进行)提交事务,将状态改为
commit
二阶段提交过程:(这个图也能帮我们了解清楚,一条更新语句的执行过程)
调换顺序存在的问题:
情况 1:假设先写
redo log再写bin log:假如写完
redo log后 mysql 崩溃重启,由于写了redo log,所以会恢复这个数据,但是bin log没有写入,所以如果之后使用bin log恢复数据,就会与原库不同情况 2:假设先写
bin log再写redo log:假如写完
bin log后 mysql 崩溃重启,由于还没写redo log,崩溃后恢复,两个文件不一致,判断此事务无效;虽然原库虽然会无此数据,但使用bin log恢复后,新的数据与原库不同;
双一规则
写redolog和写binlog,都需要先write进内存中的文件,再等待fsync刷回磁盘
双一规则就是Mysql提供了两个参数,控制write和fsync的次数
sync_binlog=1 : binlog每一次write都进行一次fsync
innodb_flush_log_at_trx_commit=1: redolog事务每提交一次就刷一次盘
为了减少刷磁盘的IO次数,使用了组提交
- redolog有一个记录事务的时序的标志LSN,假设有三个事务,第一个事务就是LSN=10,第二个就可能是LSN=60,第三个可能是LSN=120
- 在fsync时,会判断LSN,将LSN<=120的全部刷回磁盘,以减小IO次数
分库分表
概念
分库
分库是指在表数量不变的情况下对库进行切分
举例:如下图,数据库A中存放了user和order两张表,将两张表切分到两个数据库中,user表放到database A,order表放到database B![image-20240605125228332]()
分表
分表是指在库数量不变的情况下对表进行切分
举例:如下图,数据库A中存放了user表,将user表切分成user1 和 user2两张表并放到database A中![image-20240605125442246]()
分库分表
分库分表是指库和表都切分,数量都发生变化
举例:如下图,数据库 A 中存放了 user表,将 user表切分成 user1、user2、user3、user4 四张表,user1 和 user2 放到 database A中,user3 和 user4 放到 database B 中![image-20240605125519061]()


如何切分库/表?
主流的切分方式有3种:水平切分、垂直切分和混合切分
水平切分
水平分表
水平分表结构不变,将单表数据切分成多表。切分后的结果:- 每个表解结构一样
- 每个表的数据不一样
- 所有表的数据并集为全量数据
切分抽象图:
![image-20240605125813722]()
举例:如下图,order表,按照 oder_id 的数据范围水平切分后变成了 order1 和 order2 表,两个表的结构一样,数据不同
![image-20240605125834895]()
水平分库
水平分库是指,将表水平切分后分到不同数据库,使得每个库具有相同的表,表中数据不相同,水平分库一般是伴随水平分表![image-20240605130041639]()


垂直切分
垂直分表
垂直分表指将存在一张表中的字段切分到多张表。切分后的结果:
- 每个表的结构不一样;
- 每个表的数据不一样;
- 所有表的字段并集是原表的字段;
切分抽象图:
![image-20240605130131319]()
举例如下图,order表,根据字段垂直切分,切分后order_base表包含一部分字段的数据和order_info表包含另一部分字段的数据
![image-20240605130221137]()
垂直分库
垂直分库指的是,将单个库中的表分到多个库,每个库包含的表不一样。
举例:如下图,database A 中的 order 表 和 user表,垂直分库为 database A 包含 order表,database B 包含 user 表。
![image-20240605130250421]()


混合切分
混合切分其实就是水平切分和垂直切分的组合,切分抽象图如下:
举例:如下图,order表,按照 oder_id数据范围做了水平切分,并且按照表字段做了垂直切分
MVCC
多版本并发控制:读取数据时通过一种类似快照的方式将数据保存下来,这样读锁就和写锁不冲突了,不同的事务session会看到自己特定版本的数据,版本链
MVCC只在READ COMMITTED和REPEATABLE READ两个隔离级别下工作。其他两个隔离级别和MVCC不兼容,因为READ UNCOMMITTED总是读取最新的数据行,而不是符合当前事务版本的数据行。而SERIALIZABLE则会对所有读取的行都加锁
聚簇索引记录中有两个必要的隐藏列:
trx_id:用来存储每次对某条聚簇索引记录进行修改时候的事务idroll_pointer:每次对哪条聚簇索引记录有修改的时候,都会把老版本写入undo日志中。这个roll_pointer就是存了一个指针,它指向这条聚簇索引记录的上一个版本的位置,通过它来获得上一个版本的记录信息。
而读已提交和可重复读的区别就在于它们生成ReadView的策略不同
- 开始事务时创建readView,readView维护当前活动的事务id,即未提交的事务id,排序生成一个数组
- 访问数据,获取数据中的事务id(获取的是事务id最大的记录),对比readView:
- 如果在readView的左边(比readView都小),可以访问(在左边意味着事务已经提交)
- 如果在readView的右边(比readView都大)或者就在readView中,不可以访问,获取roll_pointer,取上一版本重新对比(在右边意味着,该事务在readView生成之后出现,在readView中意味着该事务还未提交)
- 读已提交隔离级别下的事务在每次查询的开始都会生成一个独立的readView,而可重复读隔离级别则在第一次读的时候生成一个readView,之后的读都复用之前的readView
这就是Mysql的MVCC,通过版本链,实现多版本,可并发读-写,写-读。通过readView生成策略的不同实现不同的隔离级别
MySql执行计划
MySQL中,执行计划(Execution Plan)是数据库查询优化器生成的一份报告,它详细描述了数据库如何执行一个特定的SQL查询。通过分析执行计划,开发者和数据库管理可以了解查询的执行效率,并据此进行优化
使用EXPLAIN语句
几个常见的主要字段
- id:查询的序列号,表示执行的顺序
- select_type:查询类型,如SIMPLE、PRIMARY、SUBQUERY、DERIVED等
- SIMPLE:简单查询不包含子查询
- PRIMARY:在包含子查询的所有查询中,最外层的查询
- SUBQUERY:子查询中的第一个SELECT
- DERIVED:派生表,即FROM子句中的子查询
- table:正在访问的表或衍生表
- partitions:匹配的分区
- type:连接类型,如ALL、INDEX、RANGE、REF、EQ_REF、CONST、SYSTEM等
- SYSTEM:表示只有一行,这是最好的连接类型
- CONST:表中只有一行匹配,通常因为主键或唯一索引的查找
- EQ_REF:使用主键或唯一索引查找,返回行数为1
- REF:使用普通索引进行查找
- FULLTEXT:使用全文索引进行查找
- INDEX:全索引查找
- possbile:可能使用的索引
- key:实际使用的索引
- key_len:使用的索引的长度
- ref:索引列上使用的列或常量
- rows:估计需要检查的行数
- filitered:估计需要检查的行数
- Extra:额外的信息
- Using filesort:MySQL需要额外的排序操作
- Using temporary:MySQL需要创建临时表来存储结果
- Using index:查询直接使用了索引
- Using Where:Where条件在索引查找中被使用
- Using index condition:索引下堆